
Paramètres
Quelques choix, conçus pour fonctionner avec n'importe quel modèle.
GénéralRaisonnementModèleCarte des expertsAccélération GPUMémoireChemins
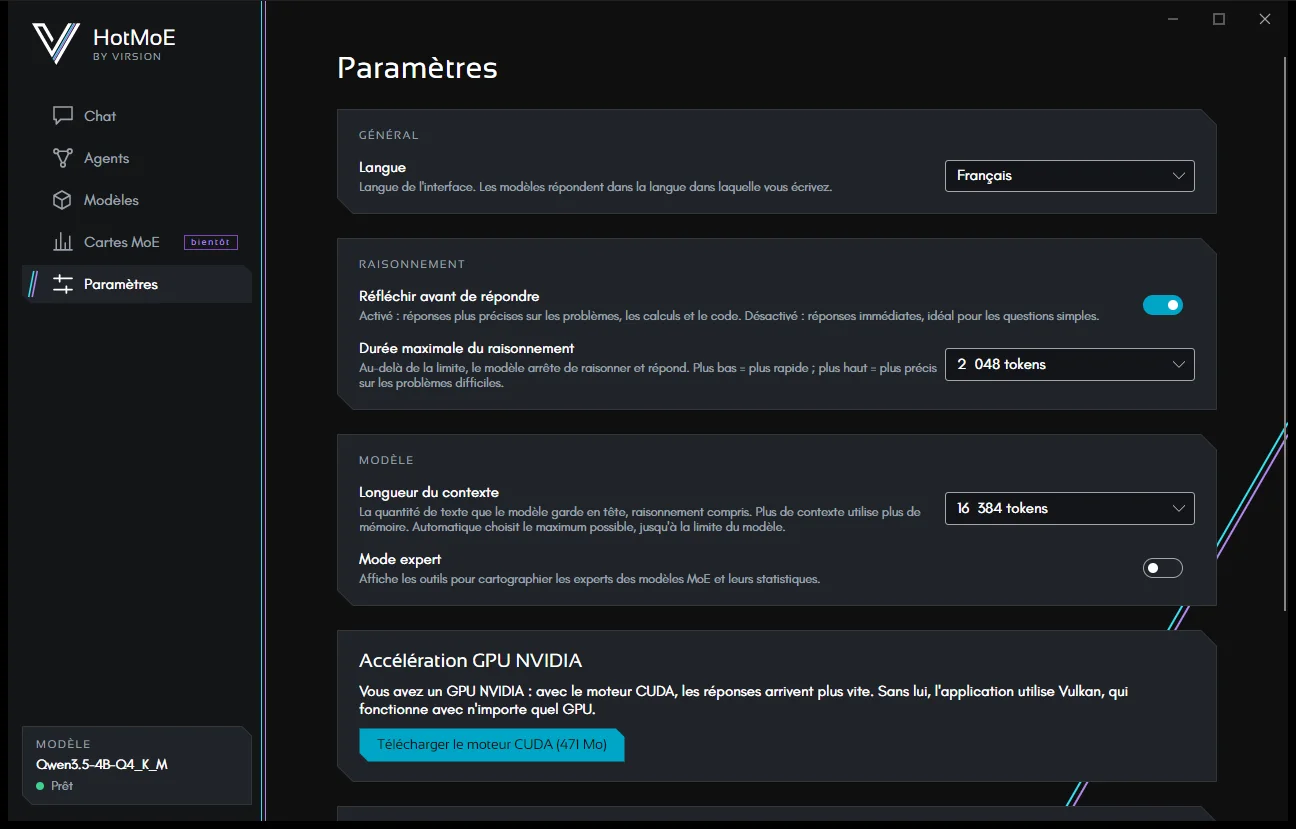
Les paramètres de raisonnement et de contexte s'appliquent après le rechargement du modèle : quand vous les modifiez, un avis apparaît avec le bouton Recharger le modèle (quelques secondes pour les petits modèles). La langue change immédiatement.
Général
Langue de l'interface : anglais, italien, français, allemand ou espagnol, ou Automatique, qui suit la langue du système. Le changement est immédiat, sans redémarrage ; les nombres, les dates et les unités suivent la langue choisie. Les modèles répondent toujours dans la langue dans laquelle vous écrivez.
Copier le texte sélectionné : le texte que vous sélectionnez dans les réponses va directement dans le presse-papiers, avec un bref avis. Désactivé, on copie seulement avec Ctrl+C ou le bouton droit. S'applique immédiatement.
Raisonnement
- Réfléchir avant de répondre : activé, il donne des réponses plus précises sur les problèmes, les calculs et le code ; désactivé, il donne des réponses immédiates, idéal pour les questions simples.
- Durée maximale du raisonnement : au-delà de cette limite, le modèle arrête de raisonner et répond. Plus bas, c'est plus rapide ; plus haut, c'est plus précis sur les problèmes difficiles.
| Durée | Tokens de raisonnement |
|---|---|
| Court | 1 024 |
| — | 2 048 · 4 096 |
| Standard (par défaut) | 8 192 |
| — | 16 384 · 32 768 |
| Long | 65 536 |
| Sans limite | Le raisonnement peut durer jusqu'à remplir le contexte : avec les petits modèles, même de nombreuses minutes. L'app vous avertit. |
En plus du raisonnement, chaque réponse dispose de 16 384 tokens de texte au maximum.
Modèle
- Longueur du contexte : la quantité de texte que le modèle garde en tête, raisonnement compris. Automatique (par défaut) choisit le contexte le plus long qui garde tout le modèle sur la carte graphique, mais au moins 16K (plus si la limite du raisonnement l'exige) ; sinon, de 4 096 à 262 144 tokens. Plus de contexte utilise plus de mémoire : un contexte fixe trop long déplace des parties du modèle sur le CPU et le ralentit beaucoup (Qwen3.8-27B sur une RTX 5080 : 17 tokens/s avec 16K, 10 avec 64K). Pendant que le modèle tourne, le bouton du contexte dans le chat affiche la longueur choisie. Avec une carte des experts, la priorité du contexte automatique décide comment répartir la mémoire de la carte graphique : Vitesse (par défaut) la donne presque entièrement aux experts les plus utilisés ; Équilibre s'arrête quand d'autres experts accélèrent peu et donne le reste au contexte (sur les grandes cartes, le contexte augmente beaucoup) ; Contexte long garde au moins 32K. Avec plus de contexte, les longues conversations sont aussi compactées moins souvent.
- Si le contexte est plus petit que la limite de raisonnement, l'app vous avertit : le modèle l'épuiserait avant de répondre.
- Mode expert : affiche les outils pour créer les cartes des experts des modèles MoE sur vos propres textes (voir Créer une carte).
Carte des experts
- Utiliser la carte des experts (activé par défaut) : quand le modèle a une carte, ses experts les plus utilisés restent en RAM. Voir Utiliser une carte.
- RAM à laisser libre : l'app ne verrouille jamais plus que votre RAM totale moins cette quantité (de 512 Mo à 32 Go, 12 Go par défaut). Seule la partie verrouillée compte : le reste du modèle est du cache que Windows rend aux autres programmes. En dessous de 4 Go, l'app prévient que le PC peut devenir lent.
- Fidélité sélective : Désactivée, Équilibrée (recommandée) ou Rapide. Détails dans Fidélité sélective.
- VRAM pour les experts (visible en mode expert) : garde sur la carte graphique les experts les plus utilisés de la carte, que le GPU calcule à la place du CPU. Automatique (par défaut) utilise la VRAM qui reste après le contexte choisi ; vous pouvez aussi la fixer de 2 à 12 Go ou la désactiver. Plus de VRAM pour les experts signifie des réponses plus rapides mais moins de contexte : sur Qwen3-235B avec une RTX 5080, l'écriture passe de 4,1 à 5,5 tokens/s avec 6 Go et à 6,1 avec 8 Go. Une valeur fixe qui ne tient pas avec le contexte choisi est réduite. Il faut une carte avec le classement des experts (régénérée avec
build_plan.pydepuis le 29/09/2026). - En dessous, l'app vous indique s'il existe une carte pour le modèle actuel, combien de RAM elle verrouille, si elle est utilisée ou pourquoi elle ne l'est pas (trop grande pour votre RAM, verrouillage échoué).
Comme le contexte, ces réglages s'appliquent après le rechargement du modèle. Le contexte et la fidélité se changent aussi depuis le chat, avec le bouton à côté d'Accès (voir Chat).
Accélération GPU
Avec une carte NVIDIA, vous pouvez télécharger ici le moteur CUDA si vous ne l'avez pas fait au premier démarrage. Détails dans Premiers pas.
Mémoire
Se souvenir d'une conversation à l'autre est désactivé par défaut. Quand vous l'activez, le chat peut :
- enregistrer de courtes notes sur vous (préférences, personnes, faits récurrents) quand vous dites quelque chose à retenir ou lui demandez de s'en souvenir : « souviens-toi que mon comptable est Paolo Verdi ». Chaque note enregistrée apparaît dans la conversation comme une étape Mémorise ;
- chercher dans vos conversations passées quand vous évoquez quelque chose dont vous avez déjà parlé (« combien coûtait le devis de la cuisine ? »).
Les notes enregistrées entrent dans chaque nouvelle conversation. Dans cette section, vous les voyez toutes avec leur date, vous en ajoutez une à la main, en oubliez une (Oublier) ou toutes (Tout oublier). Si vous désactivez la mémoire, le chat ne les utilise plus, mais elles restent ici jusqu'à ce que vous les supprimiez. En haut du chat, · mémoire activée vous rappelle qu'elle est active.
Le chat n'enregistre que ce que vous lui dites de vous, jamais le contenu d'e-mails ou de fichiers. Tout reste sur cet ordinateur.
Chemins
- Données de l'application : paramètres, historique, agents et tout le reste. Ouvrir le dossier des données l'affiche dans l'Explorateur de fichiers. Son contenu est expliqué dans Confidentialité et sécurité.
- Modèles : l'emplacement des modèles téléchargés.
- Moteur : le moteur utilisé, avec son type (Vulkan ou CUDA) et sa version.
HotMoE est un projet Virsion. Ce guide décrit l'app telle qu'elle est aujourd'hui : ce qui est encore à venir est indiqué comme tel.