
Einstellungen
Wenige Optionen, die mit jedem Modell funktionieren.
AllgemeinÜberlegungenModellExpertenkarteGPU-BeschleunigungGedächtnisPfade
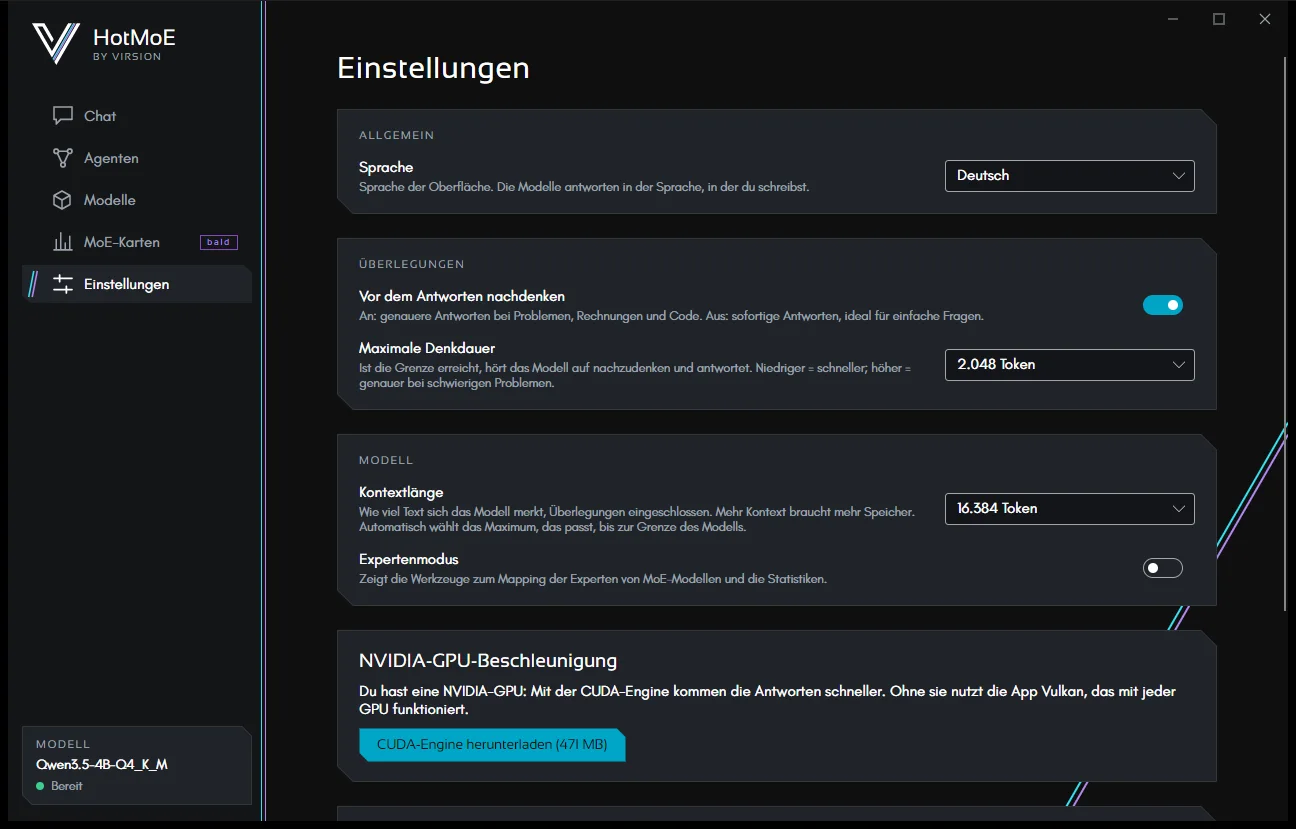
Die Einstellungen für Überlegungen und Kontext gelten nach dem Neuladen des Modells: Wenn du sie änderst, erscheint ein Hinweis mit der Schaltfläche Modell neu laden (wenige Sekunden bei kleinen Modellen). Die Sprache wechselt sofort.
Allgemein
Sprache der Oberfläche: Englisch, Italienisch, Französisch, Deutsch oder Spanisch, oder Automatisch, das der Systemsprache folgt. Der Wechsel erfolgt sofort, ohne Neustart; Zahlen, Datumsangaben und Einheiten richten sich nach der gewählten Sprache. Die Modelle antworten weiterhin in der Sprache, in der du schreibst.
Markierten Text kopieren: Text, den du in Antworten markierst, landet sofort in der Zwischenablage, mit einem kurzen Hinweis. Ausgeschaltet kopierst du nur mit Strg+C oder der rechten Maustaste. Gilt sofort.
Überlegungen
- Vor dem Antworten nachdenken: An gibt genauere Antworten bei Problemen, Rechnungen und Code; Aus gibt sofortige Antworten, ideal für einfache Fragen.
- Maximale Denkdauer: Ist diese Grenze erreicht, hört das Modell auf nachzudenken und antwortet. Niedriger ist schneller, höher ist genauer bei schwierigen Problemen.
| Länge | Token für Überlegungen |
|---|---|
| Kurz | 1.024 |
| — | 2.048 · 4.096 |
| Standard (Voreinstellung) | 8.192 |
| — | 16.384 · 32.768 |
| Lang | 65.536 |
| Ohne Grenze | Das Nachdenken kann dauern, bis der Kontext voll ist: bei kleinen Modellen auch viele Minuten. Die App weist dich darauf hin. |
Zusätzlich zu den Überlegungen hat jede Antwort bis zu 16.384 Token Text.
Modell
- Kontextlänge: wie viel Text sich das Modell merkt, Überlegungen eingeschlossen. Automatisch (Standard) wählt den längsten Kontext, bei dem das ganze Modell auf der Grafikkarte bleibt, aber mindestens 16K (mehr, wenn die Grenze für Überlegungen es verlangt); sonst von 4.096 bis 262.144 Token. Mehr Kontext braucht mehr Speicher: Ein zu langer fester Kontext verschiebt Teile des Modells auf die CPU und macht es deutlich langsamer (Qwen3.8-27B auf einer RTX 5080: 17 Token/s mit 16K, 10 mit 64K). Während das Modell läuft, zeigt die Kontext-Schaltfläche im Chat die gewählte Länge. Mit einer Expert-Karte entscheidet die Priorität des automatischen Kontexts, wie der Grafikspeicher aufgeteilt wird: Geschwindigkeit (Standard) gibt fast alles den meistgenutzten Experts; Ausgewogen hört auf, sobald weitere Experts kaum noch beschleunigen, und gibt den Rest dem Kontext (auf großen Karten wächst der Kontext stark); Langer Kontext behält mindestens 32K. Mit mehr Kontext werden lange Unterhaltungen außerdem seltener komprimiert.
- Ist der Kontext kleiner als die Denkgrenze, warnt dich die App: Das Modell würde ihn aufbrauchen, bevor es antwortet.
- Expertenmodus: Zeigt die Werkzeuge, um Expertenkarten für MoE-Modelle aus deinen eigenen Texten zu erstellen (siehe Eine Karte erstellen).
Expertenkarte
- Expertenkarte verwenden (standardmäßig an): Hat das Modell eine Karte, bleiben die meistgenutzten Experten im RAM. Siehe Eine Karte verwenden.
- Frei zu lassender RAM: Die App sperrt nie mehr als deinen gesamten RAM minus diese Menge (von 512 MB bis 32 GB, standardmäßig 12 GB). Nur der gesperrte Teil zählt: Der Rest des Modells ist Cache, den Windows anderen Programmen zurückgibt. Unter 4 GB warnt die App, dass der PC langsam werden kann.
- Selektive Treue: Aus, Ausgewogen (empfohlen) oder Schnell. Details unter Selektive Treue.
- VRAM für Experten (im Expertenmodus sichtbar): hält die meistgenutzten Experten der Karte auf der Grafikkarte, wo die GPU sie statt der CPU berechnet. Automatisch (Standard) nutzt den VRAM, der nach dem gewählten Kontext übrig bleibt; du kannst ihn auch auf 2 bis 12 GB festlegen oder ausschalten. Mehr VRAM für Experten heißt schnellere Antworten, aber weniger Kontext: Bei Qwen3-235B mit einer RTX 5080 steigt die Ausgabe von 4,1 auf 5,5 Token/s mit 6 GB und auf 6,1 mit 8 GB. Ein fester Wert, der mit dem gewählten Kontext nicht passt, wird verkleinert. Nötig ist eine Karte mit der Rangfolge der Experten (seit dem 29.09.2026 mit
build_plan.pyneu erzeugt). - Darunter zeigt die App, ob es eine Karte für das aktuelle Modell gibt, wie viel RAM sie sperrt, ob sie verwendet wird oder warum nicht (zu groß für deinen RAM, Sperren fehlgeschlagen).
Wie der Kontext gelten diese Einstellungen nach dem Neuladen des Modells. Kontext und Treue lassen sich auch im Chat ändern, mit der Schaltfläche neben Zugriff (siehe Chat).
GPU-Beschleunigung
Mit einer NVIDIA-Karte kannst du hier die CUDA-Engine herunterladen, falls du das beim ersten Start nicht getan hast. Details unter Erste Schritte.
Gedächtnis
Über Unterhaltungen hinweg erinnern ist standardmäßig aus. Wenn du es einschaltest, kann der Chat:
- kurze Notizen über dich speichern (Vorlieben, Personen, wiederkehrende Fakten), wenn du etwas Merkenswertes sagst oder ihn bittest, sich etwas zu merken: „Merk dir, dass mein Steuerberater Paolo Verdi heißt“. Jede gespeicherte Notiz erscheint in der Unterhaltung als Schritt Merkt sich;
- deine früheren Unterhaltungen durchsuchen, wenn du dich auf etwas beziehst, worüber ihr schon gesprochen habt („Wie viel hat das Küchenangebot gekostet?“).
Gespeicherte Notizen fließen in jede neue Unterhaltung ein. In diesem Bereich siehst du alle mit Datum, fügst eine von Hand hinzu, vergisst eine (Vergessen) oder alle (Alles vergessen). Schaltest du das Gedächtnis aus, nutzt der Chat sie nicht mehr, aber sie bleiben hier, bis du sie löschst. Oben im Chat erinnert dich · Gedächtnis an daran, dass es aktiv ist.
Der Chat speichert nur, was du ihm über dich sagst, nie Inhalte aus E-Mails oder Dateien. Alles bleibt auf diesem Computer.
Pfade
- App-Daten: Einstellungen, Verlauf, Agenten und alles andere. Datenordner öffnen zeigt ihn im Datei-Explorer. Was er enthält, steht unter Datenschutz und Sicherheit.
- Modelle: wo die heruntergeladenen Modelle liegen.
- Engine: die verwendete Engine, mit ihrem Typ (Vulkan oder CUDA) und ihrer Version.
HotMoE ist ein Projekt von Virsion. Dieses Handbuch beschreibt die App so, wie sie heute ist: Was noch kommt, ist als solches gekennzeichnet.