
Modelos
El modelo es el «cerebro» que responde. HotMoE lo ejecuta en tu ordenador: elige el que mejor se adapte a tu memoria y a lo que necesitas hacer.
PestañasCatálogoRecomendadosDescargaTus archivosCuál elegirMixture-of-Experts
Las dos pestañas
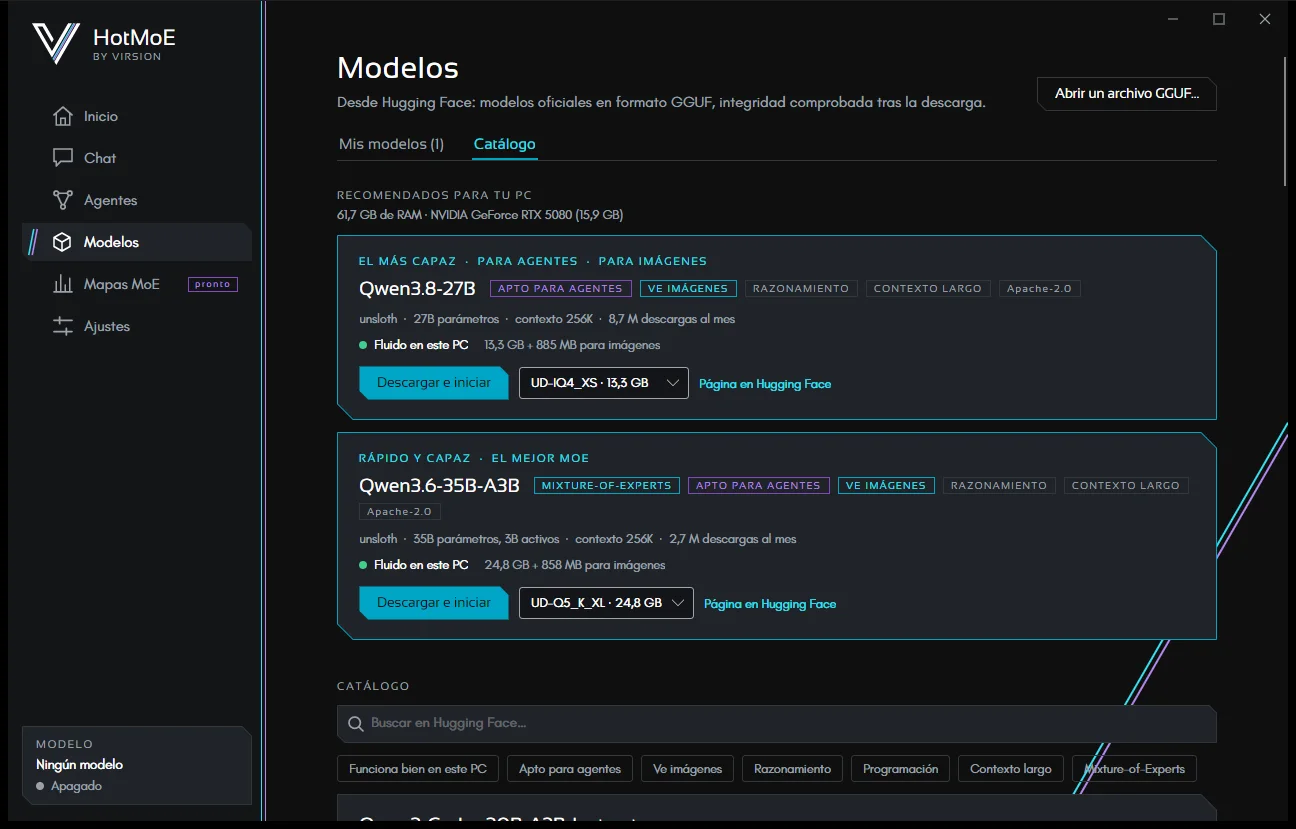
Arriba, debajo del título, hay dos pestañas:
- Mis modelos: la carpeta de modelos, con Abrir carpeta, y los modelos que ya están en tu ordenador. El número entre paréntesis indica cuántos hay. Si no tienes ninguno, Explorar el catálogo te lleva a la otra pestaña.
- Catálogo: Recomendados para tu PC, después la búsqueda, los filtros y la lista de modelos para descargar.
La página se abre en Mis modelos si tienes modelos; si no, en Catálogo. Abrir un archivo GGUF… está arriba, fuera de las pestañas.
Catálogo
La página Modelos lee el catálogo en directo de Hugging Face, el sitio donde se publican los modelos. Muestra los modelos GGUF republicados por unsloth, ggml-org y lmstudio-community: editores que reempaquetan los modelos oficiales. Aparecen los más descargados del mes; el cuadro de búsqueda busca en Hugging Face.
Filtros
Un clic en un filtro lo activa o lo desactiva: Funciona bien en este PC, Apto para agentes, Ve imágenes, Razonamiento, Programación, Contexto largo, Mixture-of-Experts.
Las capacidades se leen de los datos del propio modelo:
- Apto para agentes: el modelo admite herramientas y tiene al menos unos 7000 millones de parámetros.
- Ve imágenes: el repositorio tiene un proyector de imágenes (un archivo
mmproj), la parte que permite al modelo ver imágenes. - Mixture-of-Experts: confirmado por la cabecera del archivo del modelo.
Qué muestra cada ficha
- Las etiquetas de capacidades, la licencia y el editor.
- Parámetros (en un Mixture-of-Experts, también los activos), longitud del contexto, descargas del mes y tamaño.
- Cómo funciona en este PC: Fluido, Utilizable, Lento, Solo con mapa de expertos: lento o Demasiado grande para este PC. La categoría con mapa es para modelos MoE de hasta unas dos veces la memoria de la RAM y la tarjeta gráfica juntas: funcionan con un mapa de expertos, que mantiene en memoria los más usados (Qwen3-235B en una RTX 5080 con 64 GB: de 4 a 6 tokens/s). La estimación sale de la memoria y la velocidad de la RAM y de la tarjeta gráfica: es una orientación, no una medida. Para las tarjetas NVIDIA más comunes, la app conoce la velocidad real de la memoria por el nombre de la tarjeta (más baja en portátiles); para las demás usa un valor prudente.
- Versión elige la cuantización, es decir, cuánto se comprime el modelo: una versión más pequeña necesita menos memoria, con una calidad algo menor. Cada ficha ya selecciona la mejor versión para este PC: la más grande que funciona con fluidez, pero no por debajo de unos 3,5 bits por peso; si no, la más grande utilizable a partir de Q4. Nunca por encima de Q6, para dejar algo de memoria libre. Si ya hay una versión del modelo en el disco, se selecciona esa.
- Un enlace abre la página del modelo en Hugging Face.
Los modelos que requieren una cuenta de Hugging Face no aparecen. El último catálogo se guarda en tu ordenador: la página lo muestra enseguida y funciona también sin conexión, con un aviso cuando Hugging Face no responde.
Recomendados para tu PC
En la parte superior de la pestaña Catálogo, hasta cinco propuestas entre los modelos más descargados:
- el más capaz que funciona de forma utilizable en tu ordenador;
- el más capaz que ya es fluido con calidad Q4: rápido sin bajar la calidad;
- el mejor para agentes;
- el mejor para imágenes;
- el mejor MoE: el Mixture-of-Experts más grande que funciona bien.
Un mismo modelo puede proponerse por más de un motivo. En el primer inicio, la página de Bienvenida propone el primer modelo recomendado.
Descargar e iniciar
- Descargar e iniciar: una descarga con progreso y tiempo restante; Pausar y continuar cuando quieras, desde donde lo dejaste.
- Al terminar la descarga, la app comprueba el tamaño y la huella SHA-256 del archivo, la que publica Hugging Face: un archivo dañado se descarta.
- Los archivos van a la carpeta de modelos, en editor/repositorio. En un modelo que ve imágenes, el proyector se descarga junto al modelo.
- Iniciar carga un modelo ya descargado. Uno cada vez: iniciar otro sustituye al que está en uso.
Tus archivos GGUF
Puedes usar cualquier modelo en formato GGUF, el formato de modelos de llama.cpp.
- Abrir un archivo GGUF… carga un modelo desde cualquier carpeta.
- Si en la carpeta del GGUF que abres hay también un archivo
mmproj*.gguf, la app lo carga también y el modelo puede ver imágenes. - Mis modelos enumera los modelos de la carpeta de modelos; los modelos divididos en varios archivos aparecen como uno solo, con el número de partes. Abrir carpeta la muestra en el Explorador de archivos.
- Los parámetros de generación vienen del propio archivo, si los contiene, o de los recomendados para la familia del modelo (Qwen, Gemma, gpt-oss, DeepSeek); si no, se usan los del motor. No hay nada que ajustar a mano.
Cuál elegir
- Para empezar: los modelos de Recomendados para tu PC.
- Archivos, correo y agentes: un modelo marcado como Apto para agentes.
- Capturas de pantalla, fotos y páginas escaneadas: un modelo marcado como Ve imágenes.
- Lento o demasiado grande: elige una Versión más pequeña, o un modelo más pequeño.
- Para ir más rápido: el motor CUDA en tarjetas NVIDIA, un contexto más corto o el razonamiento desactivado para preguntas sencillas.
Mixture-of-Experts
Un modelo Mixture-of-Experts (MoE) está formado por muchos «expertos», y para cada palabra usa solo unos pocos. Por eso un MoE de 35.000 millones de parámetros que activa unos 3000 millones cada vez responde con la calidad de un modelo grande y la velocidad de uno pequeño. Son los modelos con los que trabaja la tecnología de los Mapas MoE, que llegará próximamente.
HotMoE es un proyecto de Virsion. Esta guía describe la app tal como es hoy: lo que aún está por llegar se indica como tal.