
LLM in locale nel 2026: cos’è, quali modelli usare e di cosa ha bisogno il tuo PC
 Di Gianmarco Virzì ·
In pieno 2026, siamo nel bel mezzo della rivoluzione dell’intelligenza artificiale. L’IA viene sempre più utilizzata in disparati ambiti e risulta sempre più indispensabile.
Un LLM in locale è un modello IA che gira interamente sul tuo computer, invece che sui server di un’azienda. In questa guida vediamo cos’è, quali modelli usare e di cosa ha bisogno il tuo PC.
Un problema ignorato o forse troppo sottovalutato
La maggior parte di noi ha imparato a conoscere ed ha avuto a che fare con i modelli IA come: ChatGPT, Claude, Grok, Gemini, Mistral e tanti altri.
Proprio per il loro ampio spettro di utilizzi però c’è un problema che sta cominciando ad avere sempre più una certa rilevanza, ovvero quello della privacy. Infatti, con noncuranza tendiamo a dare a questi modelli informazioni personali, dati aziendali o addirittura vere e proprie informazioni su processi aziendali.
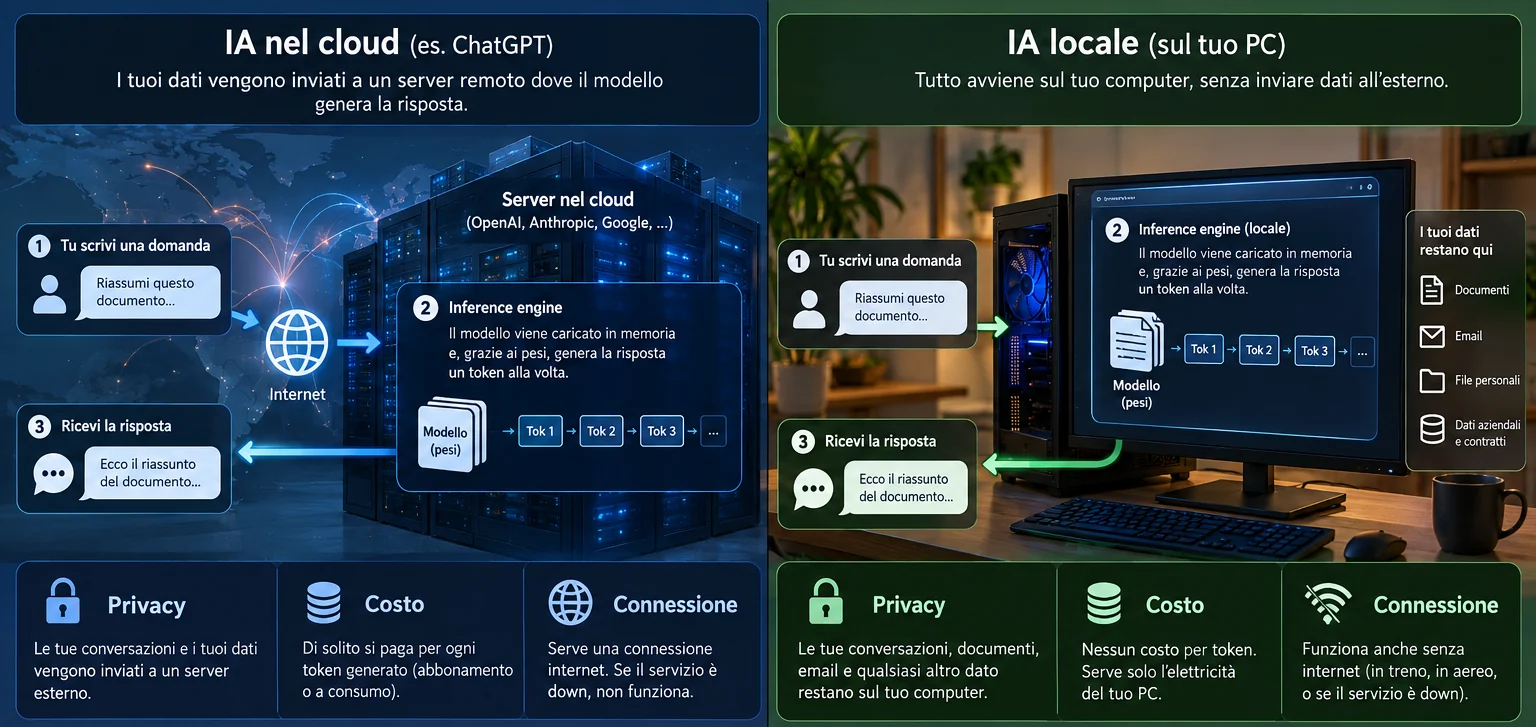
Il problema sta nel fatto che i modelli d’inferenza girano in cloud e molto più precisamente in Data Center gestiti da aziende che possono avere accesso ai nostri dati. Sia ben chiaro: l’obiettivo di questo articolo non è demonizzare l’operato di queste aziende, infatti, i dati sono protetti da norme sul trattamento e da misure di sicurezza, ma questo non cambia la realtà dei fatti. Le discussioni e i dati scambiati con questi modelli viaggiano su internet, vi risiedono e in alcuni casi potrebbero essere utilizzati per addestrare i successivi modelli (esistono metodi ed impostazioni per evitare quest’ultimo caso).
Per garantire la sicurezza dei dati esistono però gli LLM in locale, modelli IA che funzionano sul tuo computer. Per affrontare meglio le domande e i punti di questo articolo dobbiamo capire prima cosa sono.
Cos’è un LLM in locale
Gli LLM (Large Language Model), meglio conosciuti come “modelli IA”, sono file la cui dimensione può variare dai pochi gigabyte per i modelli più piccoli, fino a diverse centinaia di GB per quelli più grandi.
Dentro a questi file ci sono i cosiddetti “pesi”, sono miliardi di numeri o “parametri” che vengono imparati durante l’addestramento di questi modelli.
Per utilizzare questi file servono dei motori d’inferenza, ovvero dei programmi che riescono a caricare quei file in memoria e che grazie ai pesi scrivono un pezzo di parola alla volta, conosciuto come token.
Quando usi ChatGPT, questo accade su un server in cloud da qualche parte, con un LLM locale questo processo avviene sul tuo computer, portando a tre principali differenze:
- Privacy: le conversazioni, documenti, e-mail o qualsiasi tuo altro dato rimangono sul tuo computer. Questo per aziende (e non solo) che gestiscono dati di clienti e contratti può valere il passaggio all’utilizzo di IA locali.
- Costi: i modelli IA locali non si pagano per token generati (a differenza di quelli a pagamento) e utilizzarli non costa nulla, se non la corrente del tuo pc.
- Funzionano senza una connessione a internet: se il servizio non risponde o ti trovi in treno o in aereo (speriamo non in macchina) il modello locale ti risponderà comunque.
Bisogna però anche chiarire cosa non è un LLM locale.
Un modello locale non è una copia gratuita dei più grandi modelli cloud di frontiera come quelli già citati di OpenAI, Anthropic o Google. Infatti, quei modelli girano su hardware che nessun computer di casa può eguagliare e sui compiti estremamente difficili rimangono migliori.
Ma nell’ultimo anno la distanza si è ridotta parecchio. Per scrivere, rispondere a domande sui tuoi file, riassumere o aiutarti anche in alcuni task agentici (come scrivere mail, cercare sul tuo pc) un buon modello locale sa il fatto suo.
Ad esempio, puoi usare un modello locale per cercare informazioni sui file del tuo computer anche se questi contengono dati personali.
Di cosa ha bisogno il tuo PC per un LLM in locale
Negli ultimi due anni, proprio a causa dell’IA, l’hardware consumer è aumentato decisamente di prezzo. Quindi sapere come viene utilizzato l’hardware per l’inferenza (ovvero il processo in cui l’IA applica quanto appreso) può risultare estremamente importante.
La memoria: il modello deve stare da qualche parte
Mentre utilizziamo un modello questo deve restare aperto in memoria, e ci sono tre possibilità su dove può stare: la memoria della scheda video (VRAM), nella RAM normale o un po’ in tutte e due.
Quindi la prima domanda è “quale modello può girare sul tuo pc con la memoria che possiedi?”
I modelli IA fortunatamente si usano quasi sempre in una versione compressa, detta quantizzata. La versione a 4 bit (la riconosci perché nel nome vedrai sigle come “Q4_K_M”) è solitamente un buon compromesso, molto più leggero e con poca perdita di precisione.
A grandi linee possiamo dire che un modello occupa circa 0,6GB per miliardo di parametri, quindi un modello con 30 miliardi di parametri peserà sui 17/18GB, mentre uno da 235 miliardi di parametri tra i 125 e i 150GB.
Ma non finisce qui, perché oltre al file serve ulteriore spazio per il contesto della conversazione e il motore che legge i pesi.
La velocità: perché contano scheda video e RAM?
Per scrivere ogni token il computer ha bisogno di leggere velocemente parti diverse del modello. La velocità di generazione dei token non dipende tanto dalla potenza del processore, ma da quanto è veloce la memoria.
Una scheda video moderna è ad esempio molto più veloce della RAM. Un modello che sta tutto in VRAM sarà molto veloce, mentre lo stesso in RAM sarà molto più lento.
Quanti token servirebbero per avere un valore soddisfacente? Gli umani in media leggono a circa cinque token al secondo. Noi di Virsion reputiamo un modello usabile da 6 token al secondo e scorrevole da 15 token. Sotto questa soglia ti ritrovi ad aspettare la risposta invece di leggerla.
I modelli MoE: un cambiamento di regole
È la novità più interessante per chi utilizza modelli locali. Molti dei modelli migliori oggi sono Mixture-of-Experts, ovvero MoE. Invece di un unico blocco denso usato per ogni token, il modello viene diviso in tanti piccoli esperti e per ogni token ne lavorano solo alcuni attivando parte dei parametri di tutto il modello.
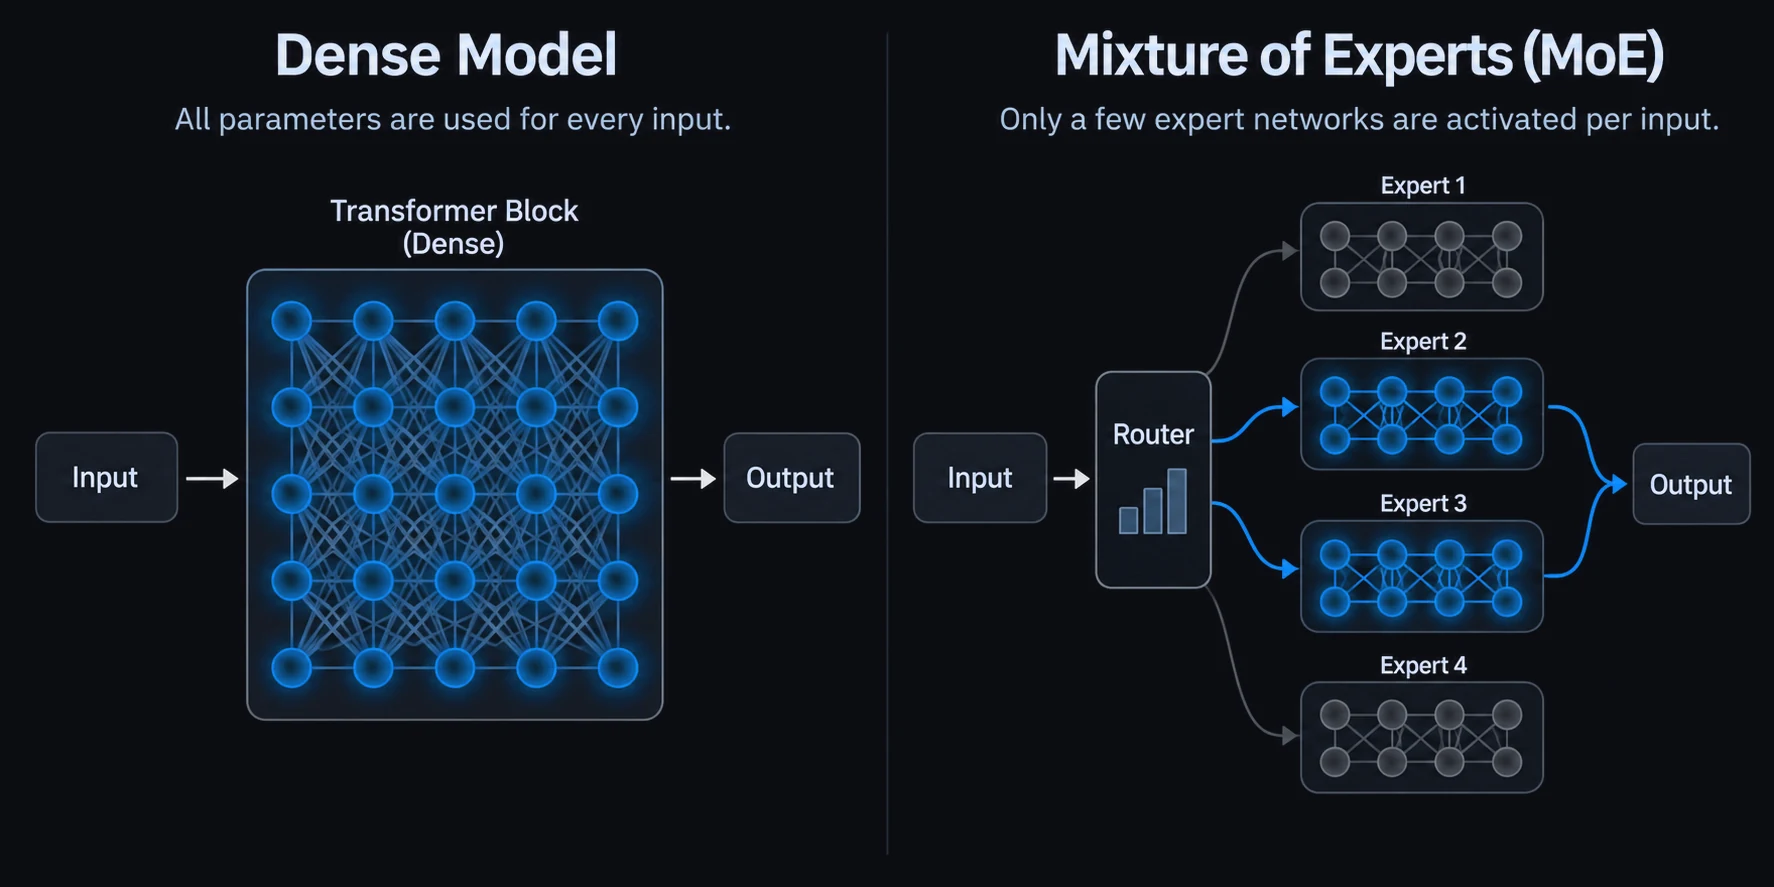
Facciamo un esempio reale: Qwen3.6-35B-A3B ha 35 miliardi di parametri ma con soli 3 attivi per token (A3B nel nome del modello significa proprio questo). Questo significa che il modello girerà bene anche se solo una parte gira sulla scheda video, mentre l’altra è nella RAM normale.
E il Mac? Apple ha investito su un altro campionato
I Mac con Apple Silicon hanno la memoria unificata. La stessa memoria viene utilizzata sia dal processore che dalla scheda grafica ed è stata costruita per avere velocità molto più alte della RAM di un normale PC. Per questo motivo i Mac sono in voga per chi utilizza l’IA locale.
| Cosa hai | Cosa provare |
|---|---|
| 16 GB di RAM, scheda video da 8 GB o nessuna | Un modello piccolo, sotto i 10 miliardi di parametri |
| 32 GB di RAM e scheda video da 8–12 GB | Qwen3.6-35B-A3B in versione Q4, diviso fra VRAM e RAM |
| Scheda video da 16 GB | Qwen3.8-27B in versione Q3, tutto in VRAM, oppure Gemma 4 26B-A4B |
I migliori modelli LLM in locale nel 2026
Nell’ultimo periodo i modelli IA escono come funghi, quindi leggi quanto segue come una fotografia di questo autunno 2026. Un consiglio che vale per sempre però è: preferisci modelli recenti (meglio ottimizzati), preferisci MoE se hai poca VRAM, e comincia da modelli piccoli.
- Qwen (Alibaba Group): la famiglia più amata e diffusa da chi usa l’IA locale. Alibaba ha rilasciato una grandissima quantità di questi modelli in diverse taglie. Qwen3.6-35B-A3B è quello che consigliamo se hai un PC con 32 o più GB di RAM: veloce, capace di seguire bene le istruzioni e adatto agli agenti.
- Modelli densi non oltre i 27B: ad esempio Qwen3.8-27B. Se hai almeno una scheda video con 16GB di VRAM la versione Q3 perde più precisione rispetto alla Q4, ma sta completamente in VRAM risultando veloce.
- Gemma (Google): Google ha rilasciato Gemma 4 in diverse taglie, compresa una versione MoE (26B-A4B) che può girare bene anche su PC di fascia media.
- I giganti: Modelli come DeepSeek-V4-Flash (284 miliardi di parametri, 13 attivi) sono il meglio dei modelli locali, ma vanno oltre ciò che un PC consumer può gestire. Ti serve un piccolo Data Center oppure hai bisogno di tecniche particolari, come quelle su cui Virsion sta lavorando.
Questi modelli (in un formato chiamato GGUF) li trovi quasi tutti su Hugging Face, il principale catalogo di modelli. La maggior parte di questi possono essere usati anche a scopo commerciale, ma verifica prima la licenza.
Come far girare un LLM in locale
Per iniziare ad usare modelli locali ci sono tre strade, tutte gratuite.
- Ollama: è l’app più diffusa tra gli sviluppatori. Permette di scaricare e far girare modelli anche in background e molte app si collegano a Ollama. Consigliato se non ti spaventa un po’ di terminale.
- LM Studio: programma con interfaccia grafica: scarica il tuo modello e inizia a chattare. Buona scelta con poco sbatti.
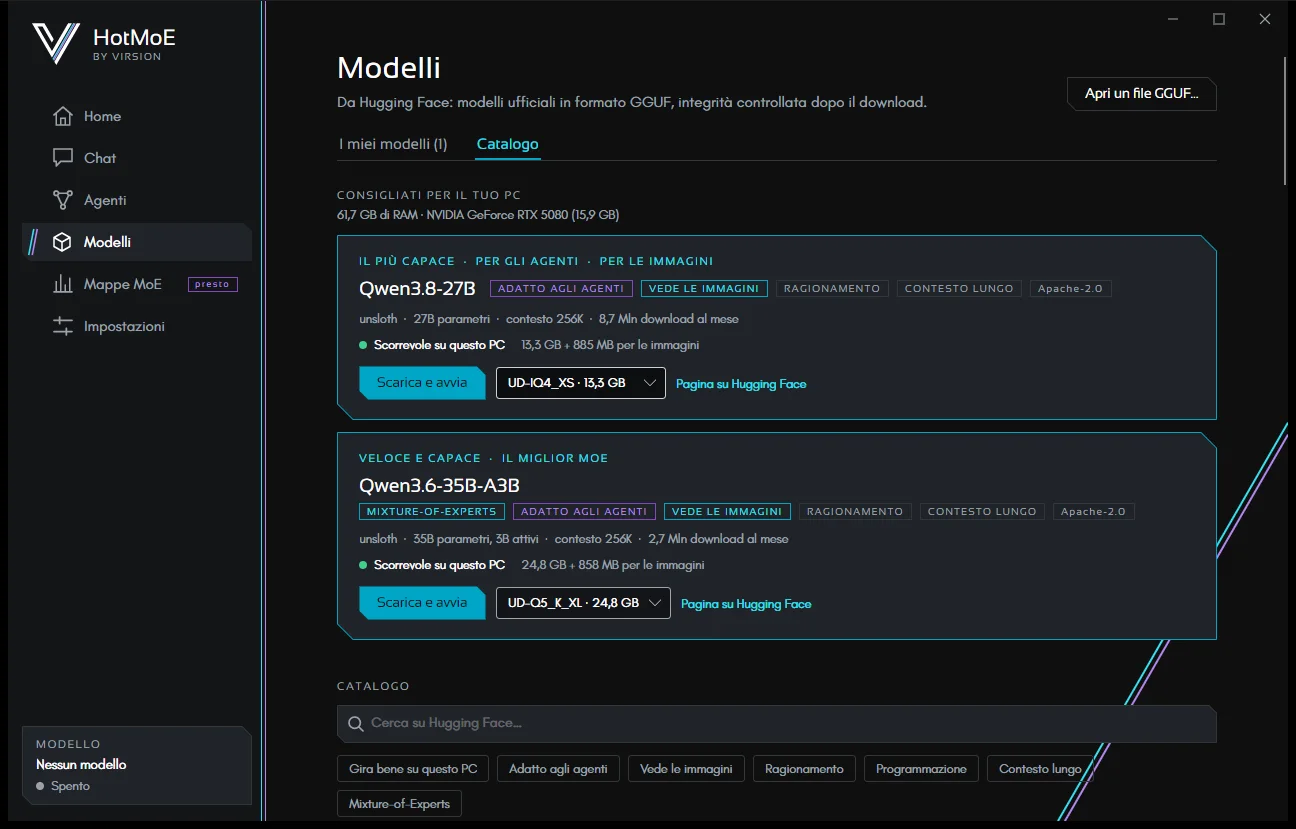
- Software Virsion in arrivo: a breve rilasceremo la nostra app Open Source per Windows, Mac e Linux. L’app sarà Plug&Play, al primo avvio verifica il tuo hardware e suggerisce i modelli più adatti al tuo PC. Possiede agenti integrati che svolgono diversi compiti come lavorare sui tuoi file, sulla tua posta, chiedendo conferma prima di agire. Ma il punto forte sta in alcune delle nostre modifiche al motore che permette di aumentare l’output di token in modelli più grandi della tua memoria. Rimani aggiornato sulla pagina: HotMoE.
Tre errori da evitare
Scaricare il modello più grande: Se il modello riempie tutta la memoria del tuo pc, rallenta tutto e la macchina risulterà inutilizzabile durante la generazione dei token. In una delle nostre prove, il modello più grande lasciava soli 200MB di RAM disponibile e si sentiva. Un po’ di margine non guasta.
Giudicare un modello subito: Ogni modello ha i suoi punti di forza, provalo in diverse situazioni. Un modello forte nel codice può essere scarso nella scrittura, e viceversa.
Dimenticarsi del contesto: a differenza dei modelli di frontiera, i modelli locali possono “tenere a mente” un contesto ridotto. Ad esempio, con documenti lunghi il motore potrebbe rifiutare la richiesta. Le app fatte bene gestiscono anche questi casi. In ogni caso, la precisione potrebbe calare, tienine conto.
Vuoi provare subito?
Apri LM Studio o Ollama e scarica un modello IA da Hugging Face. Fagli una domanda che faresti normalmente a Claude o ChatGPT e scopri se un LLM in locale fa per te.
Noi a breve rilasceremo il nostro software gratuito che permette di rendere l’esperienza plug&play e con diverse funzionalità interessanti. Controlla il nostro sito!