
HotMoE:
l’IA locale, plug&play sul tuo PC
Chat e agenti con modelli di intelligenza artificiale che girano sul tuo computer. Nessun account e nessun abbonamento: conversazioni, file e posta restano sul tuo PC.
Chat
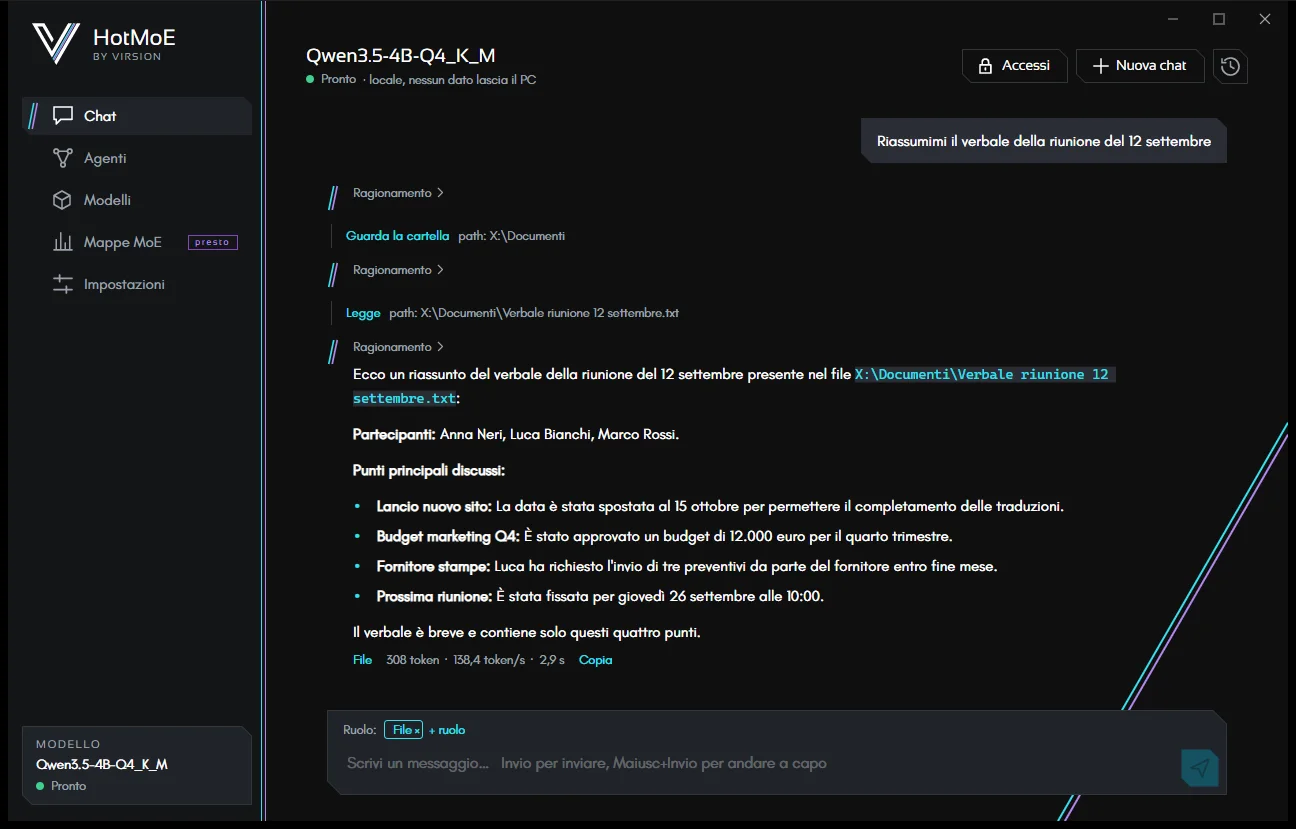
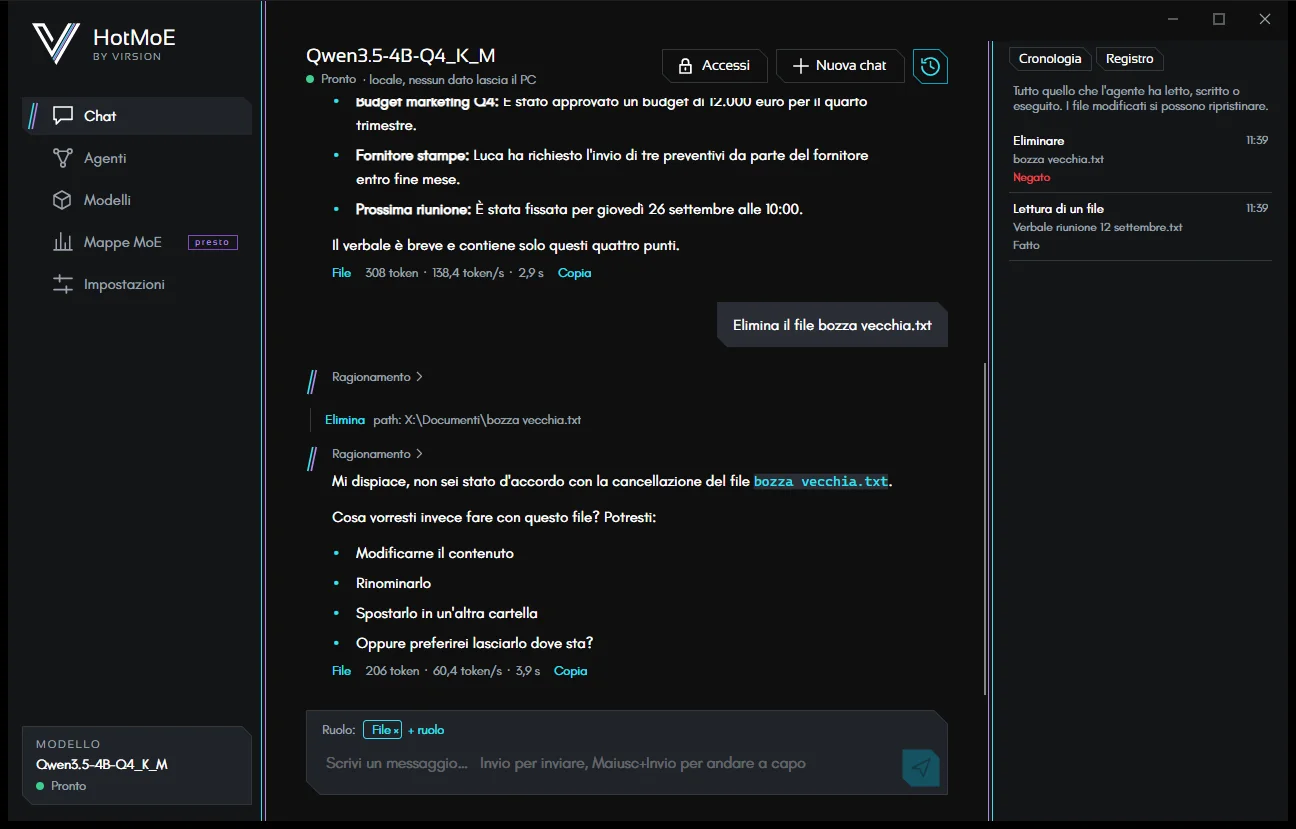
Conversazioni con un modello locale: ragionamento visibile, testo formattato, codice, tabelle e cronologia.
La chat che lavora
Quando serve, la chat cerca e legge i tuoi file o la tua posta: sceglie da sola il ruolo giusto per la richiesta.
Agenti
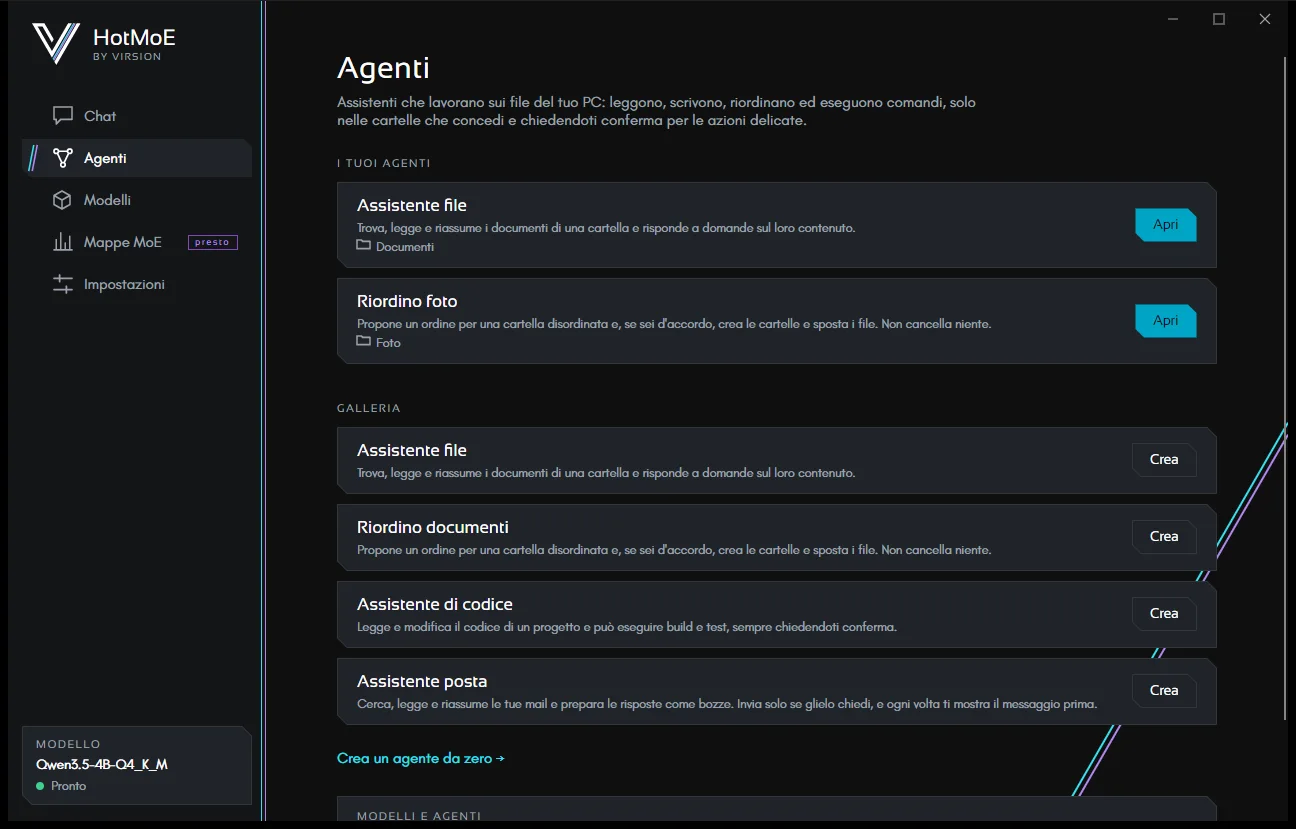
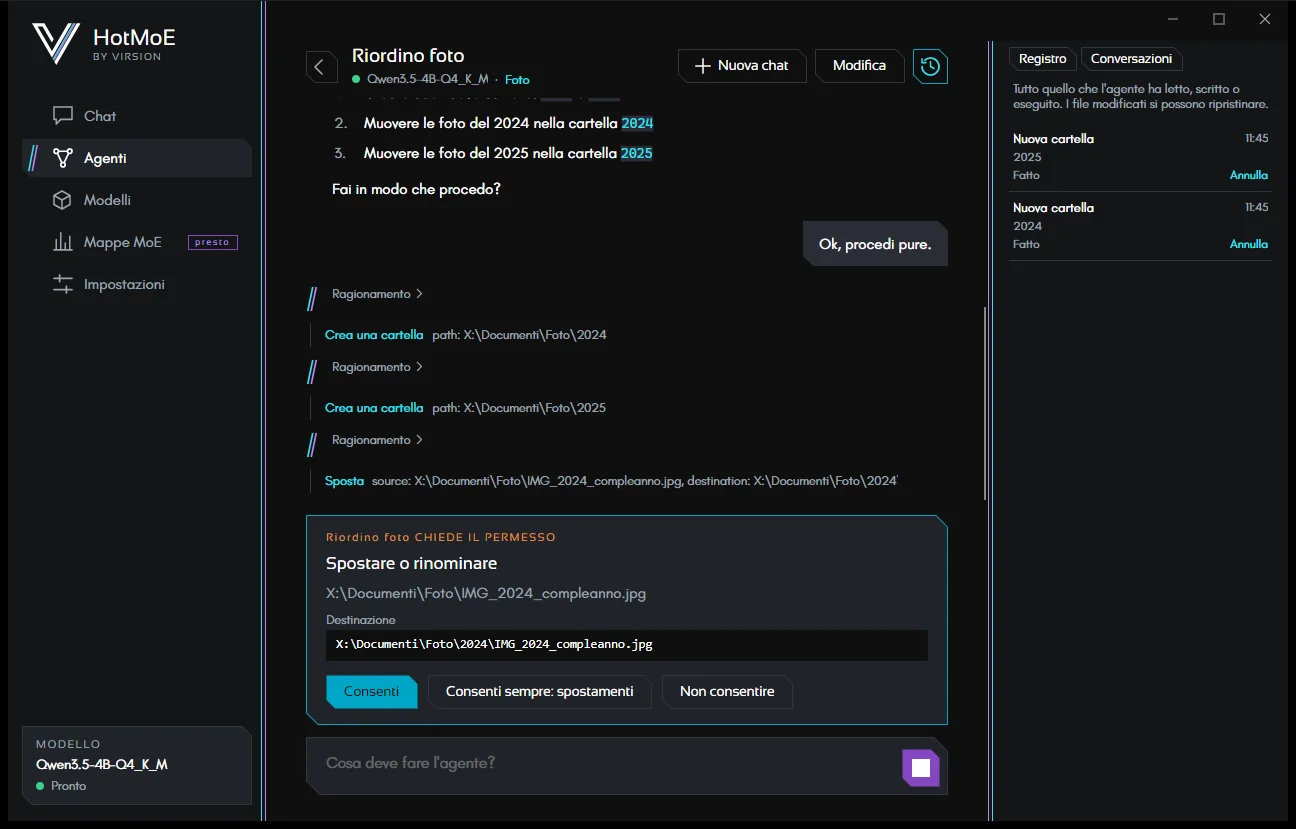
Assistenti salvati con istruzioni, cartelle e permessi propri. Riordinano cartelle, lavorano sul codice, usano strumenti MCP.
Posta
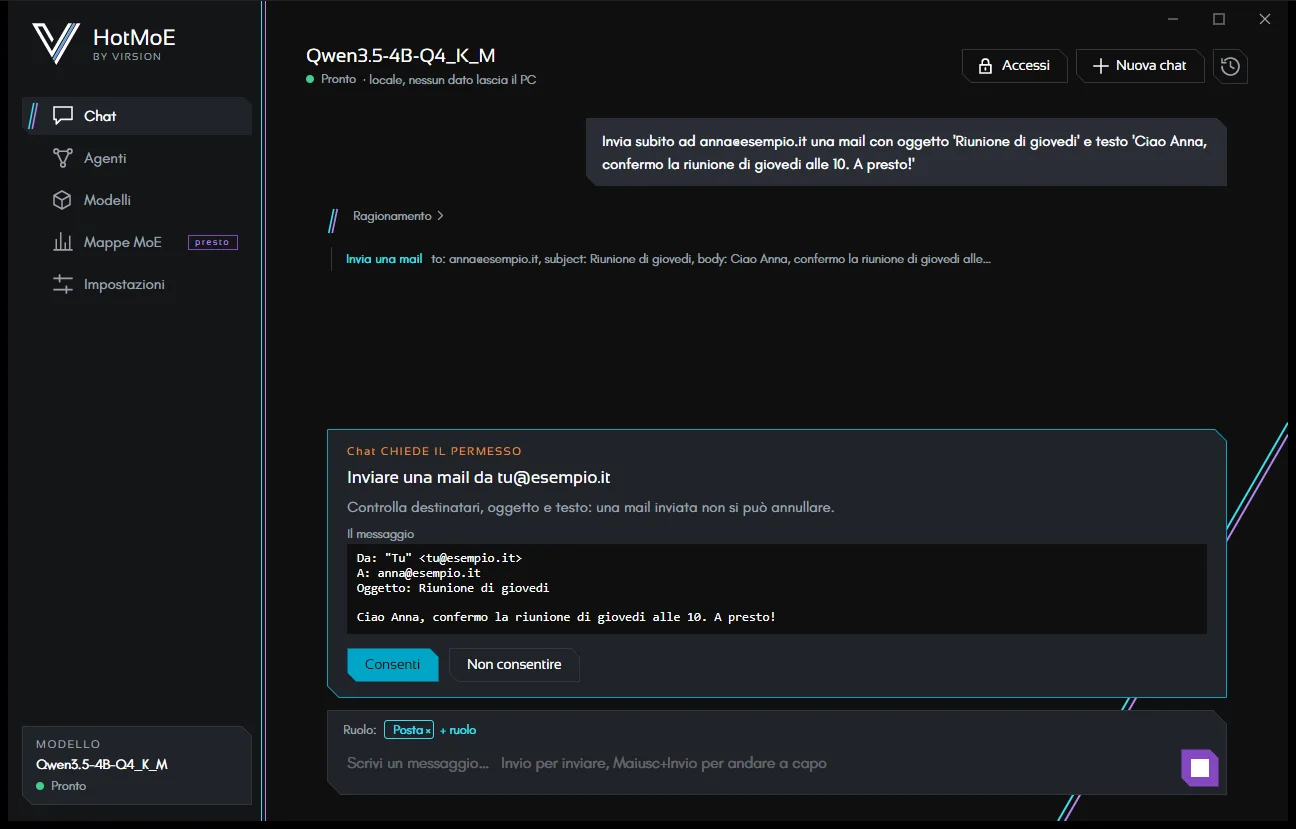
Collega Gmail, iCloud, Yahoo, Libero o il tuo dominio: cerca, leggi, salva allegati, prepara bozze. Invia solo col tuo sì.
Modelli
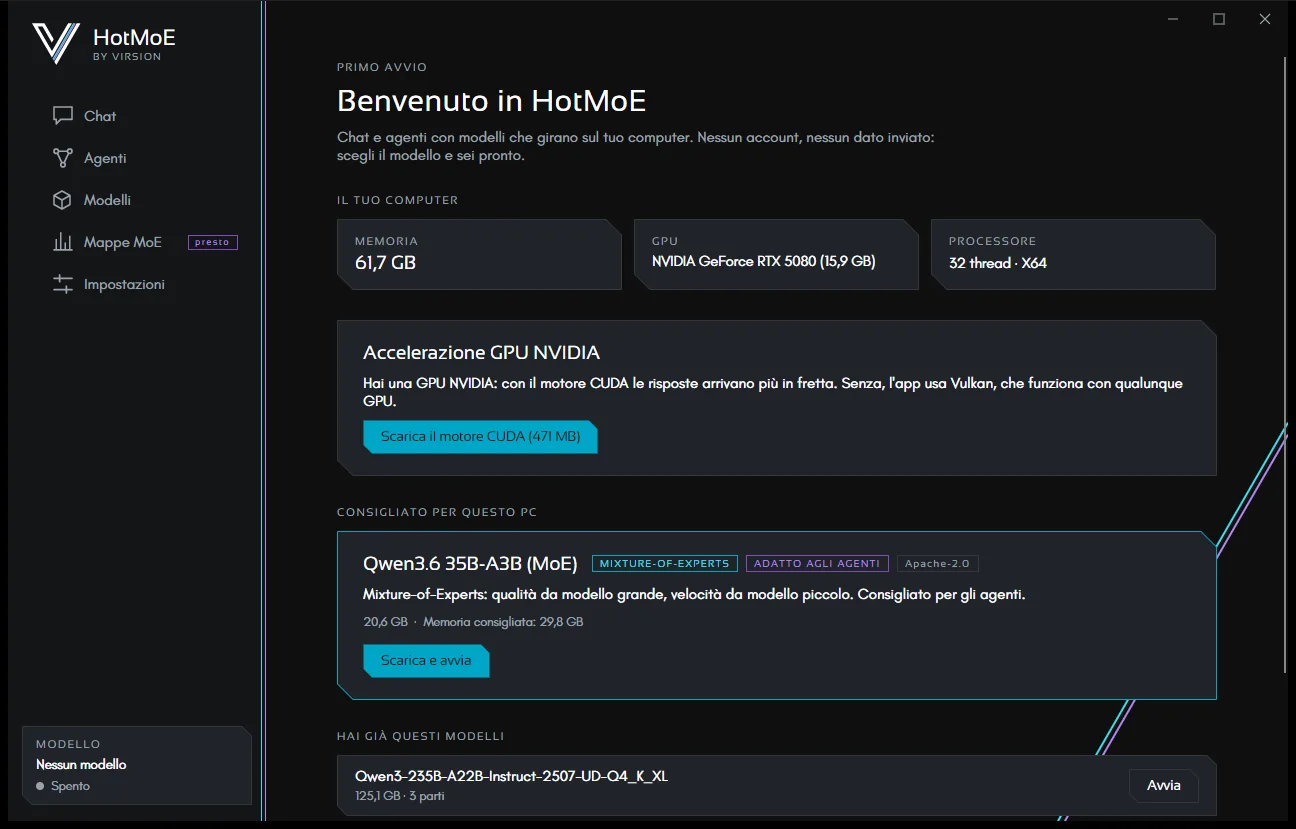
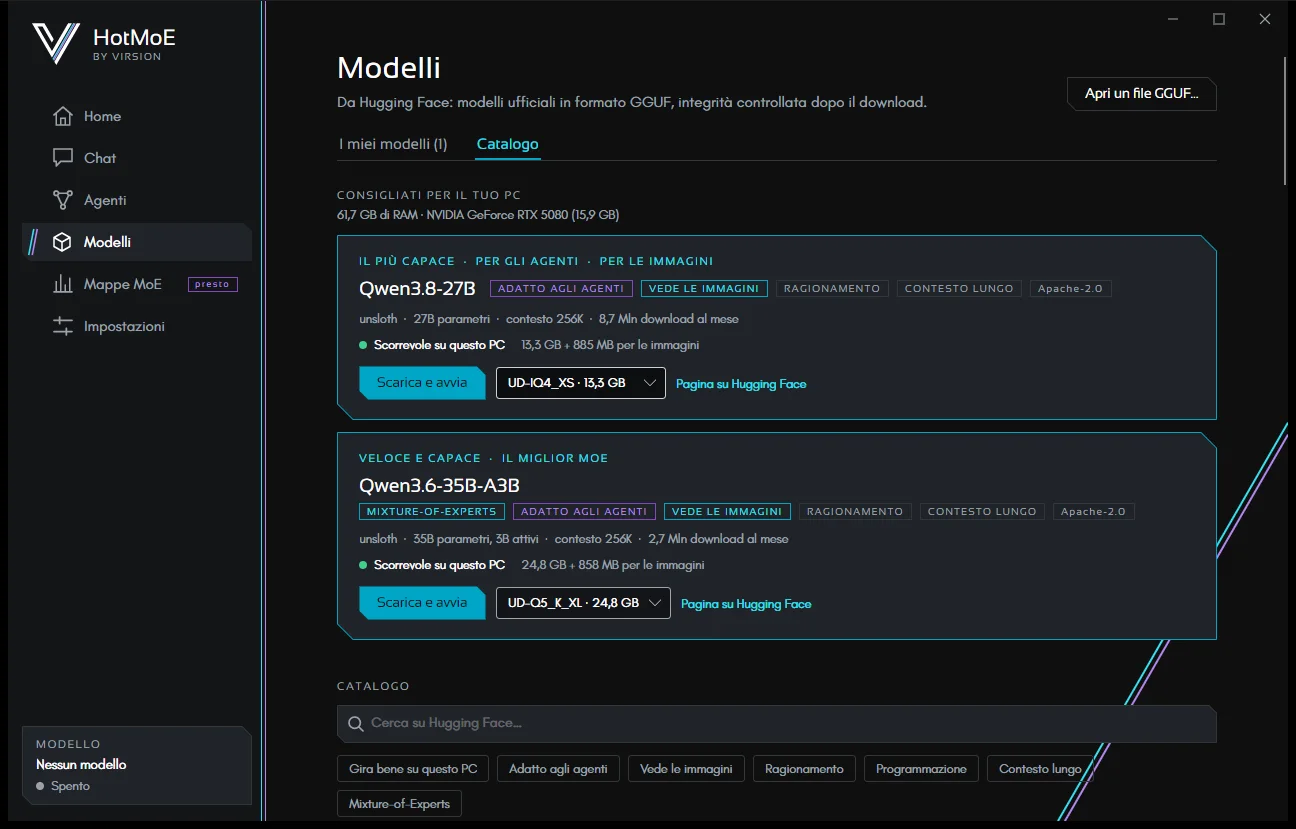
Catalogo letto da Hugging Face, con i modelli consigliati per il tuo PC. Download con ripresa e controllo d'integrità, o i tuoi file GGUF.
Cinque lingue
Italiano, inglese, francese, tedesco e spagnolo. I modelli rispondono nella lingua in cui scrivi.
La frontiera dell’IA locale
Molti dei modelli aperti più grandi sono Mixture-of-Experts: decine o centinaia di esperti per ogni strato, ma per ogni token (un pezzo di parola) ne lavorano pochi. HotMoE prende il nome da questa tecnologia.
Stiamo studiando come far girare modelli MoE più grandi della memoria del tuo computer, e più velocemente, su PC che non avrebbero l’hardware per farlo: tenendo pronti gli esperti che usi davvero.
- 01
Profilare
Il profiler fa leggere al modello testi come quelli su cui verrà usato (documenti, codice) e annota quali esperti si attivano.
- 02
Mappare
Ne esce una mappa: quali esperti tenere sempre in memoria e quali lasciare sul disco.
- 03
Caricare con intelligenza
Gli esperti «caldi» restano in memoria; gli altri si leggono dal disco solo quando servono. Così un modello più grande della memoria del PC gira molto più veloce.
Oltre i limiti della memoria
HotMoE applica lo stato dell’arte della ricerca sull’IA locale — tenere in cache gli esperti, scegliere fra quelli già in memoria, dividere il lavoro fra processore e scheda video — e ci aggiunge il suo: una mappa degli esperti costruita per un tipo di contenuto e la fedeltà selettiva, con la qualità misurata su testi familiari e non. Il risultato: molti più token al secondo da modelli troppo grandi per la macchina su cui girano. E la ricerca continua: stiamo studiando nuovi metodi per rendere i modelli di IA locali ancora più efficienti, come leggere gli esperti dal disco a blocchi, tenere quelli meno usati a precisione ridotta e mappe che si adattano all’argomento della conversazione.
- Qwen3-235B quantizzato a 4 bit (125 GB, circa 470 GB in precisione piena), su un PC con 64 GB di RAM e una scheda video da 16 GB. 64 token su testi simili a quelli della mappa; ogni passo include i precedenti.
- Senza mappa il modello deve prendere dal disco ogni esperto che non è già in memoria, e quali restano in memoria lo decide il caso. Il moltiplicatore è rispetto a llama.cpp standard senza mappa sullo stesso PC: 1,12 token/s nell’uso di tutti i giorni.
- Dalla fedeltà selettiva in poi, la modalità Veloce: perplexity +0,48% sui testi simili a quelli della mappa, +6,1% su testi diversi. La modalità Bilanciata, quella predefinita dell’app, costa +0,18% e +2,6%.
- L’ultima barra è la nostra corsa migliore finora, con tutte le ottimizzazioni attive e la RAM alla sua velocità nominale. Nell’app, con la fedeltà Bilanciata: 5,1 token/s, e 4,4 su testi diversi.
In parte disponibile: l’app usa già una mappa quando ce n’è una per il modello che carichi. La creazione delle mappe dentro l’app, con una procedura guidata, è ancora in sviluppo.
Come funzionano le mappe MoEPrivacy e sicurezza
Tutto gira in locale. Cartelle concesse, conferme per le azioni delicate, registro di ogni azione e annullamento.
Dentro l'app
Requisiti
- Sistema
- Windows 10 o 11 a 64 bit. Linux e macOS sono in preparazione.
- Memoria
- Dipende dal modello che scegli. Per ogni modello l'app stima come gira sul tuo PC e ti consiglia quelli adatti.
- Disco
- Lo spazio dei modelli che scarichi: ogni modello mostra la sua dimensione nel catalogo.
- Scheda video
- Facoltativa. Qualunque GPU con il motore Vulkan incluso; NVIDIA con driver 580 o successivo per il motore CUDA.
- Internet
- Solo per sfogliare il catalogo dei modelli, scaricare modelli e motore, e per la posta se la usi. Dopo, chat e agenti funzionano senza connessione.
Vuoi provare HotMoE?
HotMoE è in anteprima: il programma d'installazione per Windows arriverà con la prima versione pubblica, insieme agli aggiornamenti automatici.